Java Stream: guía práctica con ejemplos (Java 25)
Tienes una lista y quieres quedarte con unos elementos, transformarlos, ordenarlos o agruparlos. Con un bucle for se puede, pero el código acaba lleno de listas auxiliares y condiciones. La API Stream de Java lo resuelve en unas pocas líneas que se leen de arriba abajo.
Un Stream es como una cinta transportadora de una fábrica: los elementos salen de la lista, pasan por varias estaciones (una filtra, otra transforma, otra ordena) y al final alguien los recoge en una caja. Si nadie está esperando al final de la cinta, la cinta no arranca.
Todos los ejemplos de esta guía se han ejecutado con Java 25 (la versión LTS actual) y muestran su salida real.
Las tres partes de un Stream
List<String> nombres = users.stream()     // 1. Fuente: de dónde salen los datos
        .filter(user -> user.age() > 30)  // 2. Operaciones intermedias: devuelven otro Stream
        .map(User::name)
.toList(); // 3. Operación terminal: produce el resultado| Parte | Qué es | Ejemplos |
|---|---|---|
| Fuente | Lo que crea el Stream | lista.stream(), Stream.of(...), Arrays.stream(array) |
| Intermedia | Transforma la cinta y devuelve otro Stream. Es perezosa: no hace nada hasta que llega la terminal | filter, map, flatMap, sorted, distinct, skip, limit, gather |
| Terminal | Pone la cinta en marcha y da el resultado | toList, collect, forEach, reduce, count, anyMatch, findFirst |
¿Qué hay que importar?
Stream no es una clase sino una interfaz del paquete java.util.stream. Para llamar a lista.stream() no necesitas importar nada; solo importas lo que escribes por su nombre:
import java.util.stream.Stream;      // si usas Stream.of(...) o declaras variables Stream<T>
import java.util.stream.Collectors;  // si usas collect(Collectors.groupingBy(...)), joining...
import java.util.stream.Gatherers;   // si usas gather(...) (Java 24 o superior)
Los datos de ejemplo
Todos los ejemplos usan esta lista de usuarios. En lugar de una clase con constructor y getters, se declara con un record (disponible desde Java 16), que los genera solo: user.age() devuelve la edad.
import java.util.*;
import java.util.stream.*;

public class StreamEjemplos {

    record User(int id, String name, int age, List<String> languages) {}

    static final List<User> USERS = List.of(
            new User(1, "Marta", 18, List.of("Java", "Kotlin")),
            new User(2, "Pepe", 35, List.of("JavaScript")),
            new User(3, "Juan", 34, List.of("Java", "Ruby")),
            new User(4, "Marta", 32, List.of("Java")),
            new User(5, "Antonio", 32, List.of("Python", "Java")));

    public static void main(String[] args) {
        // Pega aquí cualquiera de los ejemplos
    }
}
Guárdalo como StreamEjemplos.java y ejecútalo sin compilar antes con java StreamEjemplos.java.
filter: quedarte con algunos elementos
filter recibe una condición (un Predicate, una función que devuelve true o false) y deja pasar solo los elementos que la cumplen. El tipo no cambia: entra una lista de usuarios y sale una lista de usuarios.
List<User> de32 = USERS.stream()
        .filter(user -> user.age() == 32)
        .toList();
de32.forEach(System.out::println);
User[id=4, name=Marta, age=32, languages=[Java]]
User[id=5, name=Antonio, age=32, languages=[Python, Java]]map: transformar cada elemento
map aplica una función a cada elemento y deja en la cinta lo que devuelve. Aquí sí puede cambiar el tipo: entran usuarios y salen números.
List<Integer> edades = USERS.stream()
        .map(User::age)
        .toList();
System.out.println(edades);
[18, 35, 34, 32, 32]User::age es una referencia a método: una forma corta de escribir user -> user.age().
sorted y distinct: ordenar y quitar repetidos
Sin argumentos, sorted usa el orden natural (alfabético para textos, de menor a mayor para números):
List<String> nombres = USERS.stream()
        .map(User::name)
        .sorted()
        .toList();
System.out.println(nombres);
[Antonio, Juan, Marta, Marta, Pepe]Para ordenar por un campo, pásale un Comparator. reversed() invierte el orden:
List<String> porEdad = USERS.stream()
        .sorted(Comparator.comparingInt(User::age).reversed())
        .map(user -> user.name() + " (" + user.age() + ")")
        .toList();
System.out.println(porEdad);
[Pepe (35), Juan (34), Marta (32), Antonio (32), Marta (18)]Y distinct elimina los repetidos:
System.out.println(USERS.stream().map(User::name).distinct().toList());[Marta, Pepe, Juan, Antonio]anyMatch, allMatch y noneMatch: preguntas de sí o no
| Método | Pregunta | ¿Algún nombre empieza por «M»? |
|---|---|---|
anyMatch |
¿Lo cumple alguno? | true |
allMatch |
¿Lo cumplen todos? | false |
noneMatch |
¿No lo cumple ninguno? | false |
System.out.println(USERS.stream().anyMatch(user -> user.name().startsWith("M")));
System.out.println(USERS.stream().allMatch(user -> user.name().startsWith("M")));
System.out.println(USERS.stream().noneMatch(user -> user.name().startsWith("M")));
true
false
falseLos tres se detienen en cuanto conocen la respuesta: anyMatch en el primer elemento que cumple, allMatch en el primero que no cumple y noneMatch en el primero que cumple. Ninguno recorre la lista entera si no hace falta.
Si solo quieres el primer elemento que cumpla algo, usa findFirst. Devuelve un Optional, una caja que puede venir vacía; orElse da el valor por defecto. Por qué Optional es mejor que devolver null lo tienes en devolver null o lanzar una excepción:
System.out.println(USERS.stream()
        .filter(user -> user.age() > 30)
        .map(User::name)
        .findFirst()
.orElse("nadie"));Pepeskip y limit: saltar, recortar y paginar
skip(n) se salta los n primeros y limit(n) se queda con los n primeros. Juntos sirven para paginar:
System.out.println(USERS.stream().skip(2).map(User::id).toList());
System.out.println(USERS.stream().limit(2).map(User::id).toList());

int pagina = 1; // la primera página es la 0
int tamano = 2;
System.out.println(USERS.stream()
        .skip((long) pagina * tamano)
        .limit(tamano)
        .map(User::id)
        .toList());
[3, 4, 5]
[1, 2]
[3, 4]Paginar así sirve para listas que ya tienes en memoria. Si los datos vienen de una base de datos, pagina en la consulta: traer todo para quedarte con dos filas es muy caro.
flatMap: aplanar listas de listas
Cada usuario tiene una lista de lenguajes. Con map obtendrías una lista de listas; flatMap las vacía todas en una sola cinta:
List<String> lenguajes = USERS.stream()
        .flatMap(user -> user.languages().stream())
        .distinct()
        .sorted()
        .toList();
System.out.println(lenguajes);
[Java, JavaScript, Kotlin, Python, Ruby]toList() o collect(Collectors.toList())
Hasta Java 15, para pasar un Stream a una lista se escribía .collect(Collectors.toList()). Desde Java 16 basta con .toList(), más corto. Hay una diferencia importante:
stream.toList()
- Disponible desde Java 16
- Devuelve una lista que no se puede modificar
- Si llamas a
add, lanzaUnsupportedOperationException
collect(Collectors.toList())
- Funciona en cualquier versión desde Java 8
- La documentación no garantiza si se puede modificar ni de qué tipo es
- Si necesitas añadir elementos, usa
Collectors.toCollection(ArrayList::new)
List<String> lista = Stream.of("Marta", "Pepe").toList();
try {
    lista.add("Juan");
} catch (UnsupportedOperationException e) {
    System.out.println("No se puede añadir: " + e.getClass().getSimpleName());
}

List<String> modificable = Stream.of("Marta", "Pepe")
        .collect(Collectors.toCollection(ArrayList::new));
modificable.add("Juan");
System.out.println(modificable);
No se puede añadir: UnsupportedOperationException
[Marta, Pepe, Juan]Collectors: joining, groupingBy, counting y compañía
collect es la operación terminal para resultados más elaborados que una lista. La clase Collectors trae los más habituales.
joining: unir textos
System.out.println(USERS.stream()
        .map(User::name)
        .distinct()
        .collect(Collectors.joining(", ", "[", "]")));
[Marta, Pepe, Juan, Antonio]Los tres argumentos son el separador, el prefijo y el sufijo. Con solo joining(", ") no hay corchetes.
groupingBy: agrupar por un campo
Es como repartir el correo en casilleros: cada usuario va al casillero de su edad.
Map<Integer, List<String>> nombresPorEdad = USERS.stream()
        .collect(Collectors.groupingBy(
                User::age,                                        // clave: la edad
                TreeMap::new,                                     // mapa ordenado por clave
                Collectors.mapping(User::name, Collectors.toList()))); // valor: los nombres
System.out.println(nombresPorEdad);
{18=[Marta], 32=[Marta, Antonio], 34=[Juan], 35=[Pepe]}Con solo groupingBy(User::age) obtienes Map<Integer, List<User>>, pero el orden de las claves no está garantizado. Si vas a mostrar el resultado o a escribir un test sobre él, pasa TreeMap::new como en el ejemplo.
counting y summingInt: contar y sumar por grupo
El tercer argumento de groupingBy decide qué se guarda en cada casillero:
Map<Integer, Long> cuantosPorEdad = USERS.stream()
        .collect(Collectors.groupingBy(User::age, TreeMap::new, Collectors.counting()));
System.out.println(cuantosPorEdad);

Map<String, Integer> sumaPorNombre = USERS.stream()
        .collect(Collectors.groupingBy(User::name, TreeMap::new, Collectors.summingInt(User::age)));
System.out.println(sumaPorNombre);
{18=1, 32=2, 34=1, 35=1}
{Antonio=32, Juan=34, Marta=50, Pepe=35}partitioningBy: separar en dos grupos
Si la clave es un sí o un no, partitioningBy siempre devuelve las dos claves, false y true:
System.out.println(USERS.stream()
        .collect(Collectors.partitioningBy(
                user -> user.age() >= 33,
                Collectors.mapping(User::name, Collectors.toList()))));
{false=[Marta, Marta, Antonio], true=[Pepe, Juan]}toMap: de lista a mapa
Map<Integer, String> nombrePorId = USERS.stream()
        .collect(Collectors.toMap(User::id, User::name));
System.out.println(nombrePorId);
{1=Marta, 2=Pepe, 3=Juan, 4=Marta, 5=Antonio}summarizingInt: estadísticas de golpe
Cuenta, suma, mínimo, media y máximo en una sola pasada. Como la edad es un int, se usa summarizingInt:
IntSummaryStatistics stats = USERS.stream()
        .collect(Collectors.summarizingInt(User::age));
System.out.println(stats);
System.out.println(stats.getAverage());
IntSummaryStatistics{count=5, sum=151, min=18, average=30.200000, max=35}
30.2reduce: combinar todo en un único valor
reduce va acumulando los elementos de dos en dos, como quien suma una lista de la compra: empieza en 0 y va añadiendo cada precio.
System.out.println(USERS.stream().map(User::age).reduce(0, Integer::sum));
System.out.println(USERS.stream().mapToInt(User::age).sum());
151
151El primer argumento (0) es el valor de partida; gracias a él, reduce devuelve directamente un número y no un Optional. Para sumar números, mapToInt(...).sum() es más claro y evita convertir cada int en Integer. Guarda reduce para combinaciones que no tengan ya un método propio.
Novedad: Stream Gatherers (Java 24 y 25)
Hasta Java 23, si querías una operación intermedia que no existiera (agrupar de tres en tres, comparar cada elemento con el anterior…), tenías que salir del Stream. Desde Java 24 existe gather, que acepta operaciones intermedias a medida (gatherers). La clase Gatherers trae cinco listas para usar: windowFixed, windowSliding, scan, fold y mapConcurrent. Como Java 25 es la versión LTS actual, ya puedes usarlos en proyectos que actualicen a ella.
windowFixed: en grupos de tamaño fijo
USERS.stream()
        .map(User::name)
        .gather(Gatherers.windowFixed(2))
        .forEach(System.out::println);
[Marta, Pepe]
[Juan, Marta]
[Antonio]Útil para procesar por lotes, por ejemplo enviar registros de cien en cien.
windowSliding: ventanas que se solapan
Cada ventana avanza un elemento. Aquí se calcula la diferencia entre cada edad y la siguiente:
System.out.println(Stream.of(18, 35, 34, 32, 32)
        .gather(Gatherers.windowSliding(2))
        .map(par -> par.get(1) - par.get(0))
        .toList());
[17, -1, -2, 0]scan: totales acumulados
Como reduce, pero emite cada resultado intermedio:
System.out.println(USERS.stream()
        .map(User::age)
        .gather(Gatherers.scan(() -> 0, Integer::sum))
        .toList());
[18, 53, 87, 119, 151]Errores habituales
Reutilizar un Stream
Un Stream solo se recorre una vez, como una cinta que no se puede rebobinar. Si lo necesitas otra vez, crea uno nuevo desde la lista.
Stream<String> nombres = Stream.of("Marta", "Pepe");
nombres.forEach(System.out::println);
nombres.forEach(System.out::println); // segunda vez: error
Marta
Pepe
java.lang.IllegalStateException: stream has already been operated upon or closedPensar que cada operación recorre toda la lista
Las operaciones intermedias son perezosas: con operaciones sin estado como filter y map, cada elemento recorre la cinta entera antes de que salga el siguiente, y solo se procesa lo necesario. Una operación con estado como sorted es distinta: necesita ver todos los elementos antes de seguir. Con println dentro se ve claro:
Stream.of("Marta", "Pepe", "Juan")
        .filter(n -> { System.out.println("filtro " + n); return n.length() == 4; })
        .map(n -> { System.out.println("map " + n); return n.toUpperCase(); })
        .findFirst()
        .ifPresent(System.out::println);
filtro Marta
filtro Pepe
map Pepe
PEPE«Juan» nunca llega a la cinta: findFirst ya tenía su respuesta. Los println están solo para enseñarlo; en código real, las funciones que pasas a filter y map no deberían tener efectos secundarios.
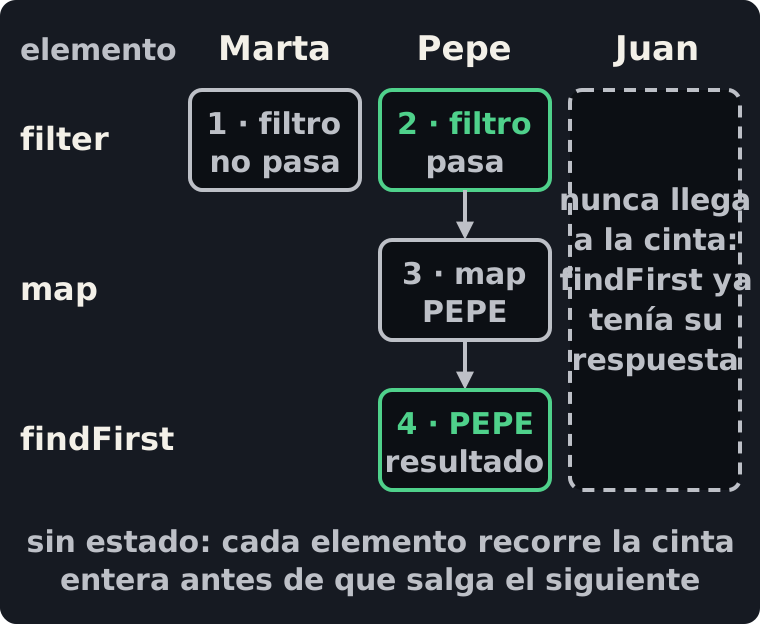
findFirst ya tiene su resultado, Juan no se procesa.Hasta que no pides el resultado, la cinta no arranca.
Encadenar demasiado
Un Stream de quince líneas con lambdas largas es tan difícil de leer como el bucle que sustituía. Extrae las condiciones a métodos con nombre (.filter(this::esMayorDeEdad)): es la misma idea que en las funciones en código limpio, funciones pequeñas que dicen lo que hacen.
Tu chuleta: quiero… → uso…
| Quiero… | Uso… |
|---|---|
| Quedarme con los que cumplen algo | filter(x -> condición) |
| Transformar cada elemento | map(x -> nuevoValor) |
| Aplanar listas de listas | flatMap(x -> x.lista().stream()) |
| Ordenar | sorted() o sorted(Comparator.comparing(...)) |
| Quitar repetidos | distinct() |
| Saltar o recortar | skip(n), limit(n) |
| Saber si alguno, todos o ninguno cumple algo | anyMatch, allMatch, noneMatch |
| El primero que cumpla algo | filter(...).findFirst() |
| Contar elementos | count() |
| Una lista (sin modificarla después) | toList() |
| Una lista que pueda modificar | collect(Collectors.toCollection(ArrayList::new)) |
| Un texto separado por comas | collect(Collectors.joining(", ")) |
| Agrupar por un campo | collect(Collectors.groupingBy(...)) |
| Contar o sumar por grupo | groupingBy(clave, Collectors.counting()), summingInt(...) |
| Separar en dos grupos | collect(Collectors.partitioningBy(...)) |
| Un mapa clave → valor | collect(Collectors.toMap(...)) |
| Suma, media, mínimo y máximo | mapToInt(...).sum(), collect(Collectors.summarizingInt(...)) |
| Combinar todo en un valor | reduce(inicial, operación) |
| Lotes de tamaño fijo (Java 24+) | gather(Gatherers.windowFixed(n)) |
| Totales acumulados (Java 24+) | gather(Gatherers.scan(...)) |
Si también programas en Kotlin, sus colecciones traen casi todas estas operaciones sin necesidad de stream(). Las diferencias entre los dos lenguajes están en Kotlin vs Java.
Siguiente paso
Coge un bucle for de tu proyecto que filtre o transforme una lista y reescríbelo con un Stream. Antes, escribe un test que fije lo que devuelve el bucle: si el test sigue en verde después del cambio, sabes que el comportamiento no ha cambiado. Es el mismo ciclo que se explica en TDD: desarrollo dirigido por tests.
Fuentes
Comprobado en noviembre de 2026 en la documentación oficial de Java SE 25: interfaz Stream (toList() desde Java 16 y no modificable; gather desde Java 24; anyMatch, allMatch y noneMatch son operaciones que se detienen antes de tiempo; reutilizar un Stream puede lanzar IllegalStateException), clase Collectors (sin garantías de tipo ni de mutabilidad en toList() y groupingBy; toMap lanza IllegalStateException con claves repetidas) y JEP 485: Stream Gatherers (definitivo en JDK 24).
Todos los ejemplos se han ejecutado con java Fichero.java en la imagen oficial de Docker eclipse-temurin:25 (OpenJDK 25.0.5, Temurin-25.0.5+8, LTS) y las salidas son las reales. Tras cambiar los nombres de ejemplo, se volvieron a ejecutar todos el 8 de noviembre de 2026, incluido el error de toMap con claves repetidas.