Estructura de un programa COBOL: las 4 divisiones
Un programa COBOL es como una receta de cocina bien escrita. Primero va el nombre del plato. Después, qué cocina y qué utensilios necesitas. Luego, la lista de ingredientes con sus cantidades. Y al final, los pasos para prepararlo. Nadie empieza a batir huevos antes de saber cuántos hay.
COBOL obliga a seguir ese mismo orden con sus cuatro divisiones. Una división es un bloque grande del programa con una función concreta:
| Orden | División | En la receta | Qué contiene |
|---|---|---|---|
| 1 | IDENTIFICATION DIVISION |
El nombre del plato | El nombre del programa y, si quieres, otros datos informativos |
| 2 | ENVIRONMENT DIVISION |
La cocina y los utensilios | Lo que depende del ordenador donde se ejecuta y qué ficheros usará |
| 3 | DATA DIVISION |
Los ingredientes | Los formatos de los ficheros y las áreas de trabajo (las variables) |
| 4 | PROCEDURE DIVISION |
Los pasos | Toda la lógica e instrucciones que queremos que haga el programa |
El símil se queda corto en una cosa: en una receta puedes saltarte la lista de ingredientes y apañarte. En COBOL, si una variable no está declarada en la DATA DIVISION, el programa no compila.
Divisiones, secciones, párrafos y frases de un programa COBOL
Cada división se puede partir en piezas más pequeñas, como un libro en capítulos, apartados y frases:
- División: el bloque grande. Termina su cabecera con
DIVISION. - Sección: un grupo dentro de la división. Su cabecera termina en
SECTION., por ejemploWORKING-STORAGE SECTION. - Párrafo: un bloque con nombre, como
FILE-CONTROL.o un párrafo de lógica llamadoPRINCIPAL.En la DATA DIVISION, las secciones no contienen párrafos, sino entradas de datos. - Frase (sentence): una o varias instrucciones que terminan en punto. Las frases son de la PROCEDURE DIVISION.
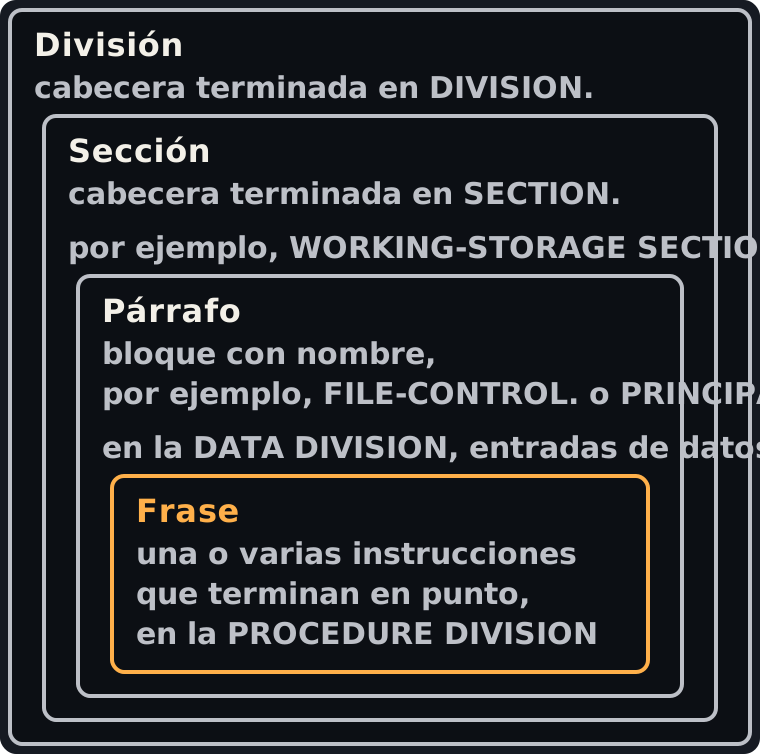
Las cabeceras de división y sección se escriben en el área A (columnas 8 a 11) y las instrucciones, en el área B (de la 12 a la 72). Lo tienes explicado columna a columna en la hoja de codificación de un programa COBOL.
Un programa completo de ejemplo
Este programa lee un fichero de ventas, suma los importes y llama a un segundo programa que añade el IVA. Es corto, pero usa las cuatro divisiones y las secciones más habituales.
El fichero ventas.txt tiene una venta por línea: 10 caracteres para el cliente y 7 cifras para el importe, de las que las 2 últimas son céntimos (0012050 son 120,50).
ANA       0012050
LUIS      0000999
MARTA     0100000
El programa principal, ventas.cbl:
       IDENTIFICATION DIVISION.
       PROGRAM-ID. VENTAS.
      * Suma los importes de un fichero de ventas.

       ENVIRONMENT DIVISION.
       CONFIGURATION SECTION.
       SOURCE-COMPUTER. LINUX.
       SPECIAL-NAMES.
           DECIMAL-POINT IS COMMA.
       INPUT-OUTPUT SECTION.
       FILE-CONTROL.
           SELECT FICHERO-VENTAS ASSIGN TO "ventas.txt"
               ORGANIZATION IS LINE SEQUENTIAL.

       DATA DIVISION.
       FILE SECTION.
       FD  FICHERO-VENTAS.
       01  REG-VENTA.
           05  VENTA-CLIENTE      PIC X(10).
           05  VENTA-IMPORTE      PIC 9(5)V99.

       WORKING-STORAGE SECTION.
       01  WS-FIN-FICHERO         PIC X VALUE "N".
           88  FIN-FICHERO        VALUE "S".
       01  WS-TOTAL               PIC 9(7)V99 VALUE ZERO.
       01  WS-TOTAL-EDITADO       PIC Z(6)9,99.

       PROCEDURE DIVISION.
       PRINCIPAL.
           OPEN INPUT FICHERO-VENTAS
           PERFORM UNTIL FIN-FICHERO
               READ FICHERO-VENTAS
                   AT END
                       SET FIN-FICHERO TO TRUE
                   NOT AT END
                       ADD VENTA-IMPORTE TO WS-TOTAL
               END-READ
           END-PERFORM
           CLOSE FICHERO-VENTAS
           CALL "IVA" USING WS-TOTAL
           MOVE WS-TOTAL TO WS-TOTAL-EDITADO
           DISPLAY "TOTAL CON IVA: " WS-TOTAL-EDITADO
           STOP RUN.
Y el subprograma iva.cbl, que recibe el total y le suma un 21 %:
       IDENTIFICATION DIVISION.
       PROGRAM-ID. IVA.

       DATA DIVISION.
       LINKAGE SECTION.
       01  LK-IMPORTE             PIC 9(7)V99.

       PROCEDURE DIVISION USING LK-IMPORTE.
           COMPUTE LK-IMPORTE ROUNDED = LK-IMPORTE * 121 / 100
           GOBACK.
Ahora vamos división por división.
1. IDENTIFICATION DIVISION
Se capturan los datos informativos del programa. Lo único obligatorio es PROGRAM-ID, el nombre con el que otros programas lo llaman: aquí, VENTAS e IVA.
Es la única división obligatoria. Un programa con solo estas dos líneas compila y se ejecuta (aunque no hace nada):
       IDENTIFICATION DIVISION.
       PROGRAM-ID. NADA.
Antes se añadían párrafos como AUTHOR o DATE-WRITTEN. Hoy están obsoletos: GnuCOBOL avisa si los usas. Para dejar esos datos, mejor un comentario (un * en la columna 7), como en el ejemplo. Tienes todos los detalles en IDENTIFICATION DIVISION en COBOL.
2. ENVIRONMENT DIVISION
Indica en qué equipo se ejecutará nuestro programa y qué archivos usará. Es la parte que cambiarías si llevas el programa a otro ordenador. Tiene dos secciones:
CONFIGURATION SECTION
Describe el ordenador y algunos ajustes del programa. Sus párrafos son SOURCE-COMPUTER (el equipo donde se compila), OBJECT-COMPUTER (donde se ejecuta), SPECIAL-NAMES y REPOSITORY. Es opcional.
En el ejemplo, SPECIAL-NAMES lleva DECIMAL-POINT IS COMMA: a partir de ahí, la coma es el separador decimal, como en España. Por eso Z(6)9,99 muestra 1367,89 y no 1367.89.
INPUT-OUTPUT SECTION
Conecta los ficheros del programa con los ficheros reales del disco. En su párrafo FILE-CONTROL, la instrucción SELECT le da un nombre interno al fichero (FICHERO-VENTAS) y ASSIGN TO dice dónde está (ventas.txt). También tiene un párrafo opcional, I-O-CONTROL.
Si tu programa no lee ni escribe ficheros, como el subprograma IVA, puedes omitir la ENVIRONMENT DIVISION entera.
3. DATA DIVISION
Define los formatos de los archivos y las áreas de trabajo que se usarán. Es la lista de ingredientes: cada dato con su nombre, su tamaño y su tipo. Sus secciones más habituales van en este orden:
| Sección | Para qué sirve | En el ejemplo |
|---|---|---|
FILE SECTION |
Sección de archivos: describe cómo es cada registro (cada línea) de los ficheros | REG-VENTA, con el cliente y el importe |
WORKING-STORAGE SECTION |
Define las áreas que se van a utilizar en el programa: variables que no vienen de un fichero. Conservan su valor entre llamadas | El total y el indicador de fin de fichero |
LOCAL-STORAGE SECTION |
Como la anterior, pero se crea de cero en cada llamada al programa | No se usa |
LINKAGE SECTION |
Describe los datos que llegan desde otro programa que nos llama | LK-IMPORTE en el subprograma IVA |
Algunas claves para leer el ejemplo:
- Los números de nivel forman jerarquías:
01es el dato completo y05son sus partes.REG-VENTAagrupa aVENTA-CLIENTEyVENTA-IMPORTE. PIC(picture) dibuja el formato del dato:X(10)son 10 caracteres cualesquiera,9(5)V99son 5 cifras enteras y 2 decimales. LaVmarca dónde va la coma, pero no ocupa espacio.- El nivel
88pone nombre a un valor:FIN-FICHEROes verdadero cuandoWS-FIN-FICHEROvale"S". Así la lógica se lee casi como una frase:PERFORM UNTIL FIN-FICHERO.
4. PROCEDURE DIVISION
Contiene toda la lógica e instrucciones que queremos que haga nuestro programa. Aquí se usan los datos definidos en la DATA DIVISION.
En el ejemplo hay un párrafo, PRINCIPAL, que:
- Abre el fichero (
OPEN INPUT). - Lee línea a línea hasta el final (
PERFORM UNTILyREAD) y va sumando los importes (ADD). - Cierra el fichero (
CLOSE). - Llama al subprograma
IVApara añadir el impuesto (CALL). - Da formato al total y lo muestra por pantalla (
MOVEyDISPLAY). - Termina el programa (
STOP RUN).
Cuando un programa recibe datos de otro, su cabecera los nombra: PROCEDURE DIVISION USING LK-IMPORTE. Y en vez de STOP RUN, que terminaría todo, el subprograma acaba con GOBACK, que devuelve el control a quien lo llamó.
Primero se dice con qué se trabaja; después, qué se hace.
Compílalo y ejecútalo tú
Puedes probarlo con GnuCOBOL, un compilador de COBOL libre. Si tienes Docker, no necesitas instalar nada en tu equipo. Guarda los tres ficheros en una carpeta y, desde ella:
docker run --rm -v "$PWD":/src -w /src debian:trixie bash -c '
  apt-get update -qq && apt-get install -y -qq gnucobol > /dev/null
  cobc -x ventas.cbl iva.cbl -o ventas
  ./ventas'
cobc -x compila y genera un ejecutable; al pasarle los dos ficheros, enlaza el programa principal con el subprograma. La salida es:
TOTAL CON IVA: 1367,89La cuenta cuadra: 120,50 + 9,99 + 1000,00 = 1130,49, y con el 21 % de IVA, 1367,89 (redondeado gracias a ROUNDED).
Si antes del resultado aparece un aviso sobre libxml, no es de tu programa: lo da el paquete de Debian y no afecta a la ejecución.
Si usas Debian o Ubuntu sin Docker, sudo apt install gnucobol y los mismos comandos cobc y ./ventas.
Dónde se guarda un programa COBOL en un mainframe: TSO e ISPF
Con GnuCOBOL trabajas en tu equipo, con ficheros y carpetas normales. En un mainframe de IBM, el programa es el mismo, pero el entorno cambia. Las dos piezas que vas a oír nada más empezar son TSO e ISPF.
- TSO/E (Time Sharing Option/Extensions) es lo que permite que muchas personas usen el mismo mainframe a la vez, cada una con su sesión. Es como un edificio de oficinas compartido: todos entran por la misma recepción, pero cada uno tiene su puesto.
- ISPF (Interactive System Productivity Facility) es el entorno de paneles en pantalla que se usa dentro de TSO/E para trabajar con los data sets y lanzar comandos de TSO/E desde menús. Sería tu mesa de trabajo, ya dentro del edificio.
Lo que más choca al principio es cómo se guardan los programas. En el almacenamiento clásico de z/OS, el que se usa con TSO e ISPF, no hay carpetas ni ficheros, sino data sets. (z/OS también tiene ficheros y carpetas, en z/OS UNIX, pero no se tratan aquí). Un data set particionado (PDS), al que también se llama biblioteca, hace de carpeta: dentro tiene miembros, que hacen de ficheros. Cada programa COBOL suele ser un miembro de una biblioteca.
El nombre de un data set son varias partes separadas por puntos, llamadas calificadores. Las reglas de la guía de TSO/E de IBM:
- Cada calificador tiene de 1 a 8 caracteres y empieza por una letra o por
$,#o@. - El nombre completo no pasa de 44 caracteres, contando los puntos. El miembro va después, entre paréntesis, y no cuenta para ese límite.
La costumbre es usar tres calificadores, que ISPF llama proyecto, grupo y tipo: el primero suele ser tu prefijo o tu usuario, el segundo lo eliges tú y el tercero dice qué contiene. Para código COBOL, el tipo de la guía de IBM es COBOL. Así, el programa de este artículo podría guardarse como:
PROY01.PRUEBAS.COBOL(VENTAS)Es la biblioteca PROY01.PRUEBAS.COBOL y, dentro, el miembro VENTAS. Si PROY01 no es tu prefijo, en los comandos de TSO el nombre va entre comillas simples, 'PROY01.PRUEBAS.COBOL(VENTAS)'; sin ellas, TSO le pone delante el tuyo.
Este apartado no se ha probado en un mainframe: las reglas de nombres salen de la documentación de IBM para z/OS 3.2 que figura en las fuentes.
Errores típicos al estructurar un programa COBOL
- Cambiar el orden de las divisiones. Siempre IDENTIFICATION, ENVIRONMENT, DATA y PROCEDURE. Lo mismo con las secciones de la DATA DIVISION.
- Olvidar los guiones. Es
WORKING-STORAGE SECTION, con guion. Sin él, no compila. - Olvidar el punto al final de las cabeceras de división, sección y párrafo.
- Pasarte de la columna 72. En formato fijo, el compilador ignora todo lo que haya a partir de ahí, y una instrucción cortada da errores difíciles de entender. GnuCOBOL es tolerante si una instrucción empieza en el área A, pero otros compiladores no lo son: respeta las áreas.
Para seguir
- Usos y reglas de COBOL: dónde se sigue usando y las reglas básicas para escribirlo.
- Qué es COBOL y su historia: de dónde viene y por qué tiene esta estructura tan ordenada.
Fuentes
Comprobado en noviembre de 2026 en la documentación oficial de IBM Enterprise COBOL for z/OS 6.5: Structuring your program (las cuatro divisiones y que solo la IDENTIFICATION DIVISION es obligatoria), Configuration section, ENVIRONMENT DIVISION y DATA DIVISION overview. IBM 6.5 añade además una TYPE SECTION opcional, que no se trata aquí. TSO e ISPF, comprobados el 13 de noviembre de 2026 en la guía de usuario de TSO/E de z/OS 3.2 (SA32-0971-70: origen del nombre, ISPF/PDF como uno de sus entornos, data sets particionados y miembros, reglas y convenciones de nombres, las comillas simples para un prefijo que no es el tuyo y el calificador COBOL) y en el curso de IBM de 2005 Introduction to ISPF (proyecto, grupo y tipo, y que a un PDS se le llama biblioteca). Compilador: GnuCOBOL 3.2, la versión estable más reciente.
Los programas del artículo se han compilado y ejecutado con GnuCOBOL 3.2.0 (paquete gnucobol de Debian 13.7, imagen debian:trixie en Docker), con la salida que se muestra.